

- 新品
- 書籍
- 書籍
- 1211-03-00
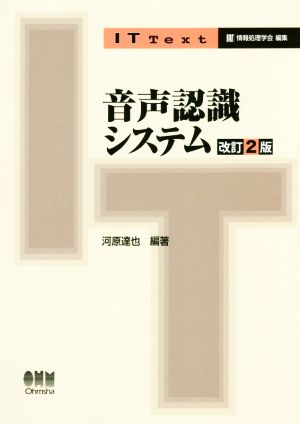
音声認識システム 改訂2版 IT text
3,850円
獲得ポイント35P
在庫なし
発送時期 1~5日以内に発送
商品詳細
| 内容紹介 | |
|---|---|
| 販売会社/発売会社 | オーム社 |
| 発売年月日 | 2016/09/01 |
| JAN | 9784274219368 |
- 書籍
- 書籍
音声認識システム 改訂2版
商品が入荷した店舗:店
店頭で購入可能な商品の入荷情報となります
ご来店の際には売り切れの場合もございます
オンラインストア上の価格と店頭価格は異なります
お電話やお問い合わせフォームでの在庫確認、お客様宅への発送やお取り置き・お取り寄せは行っておりません

値下げ前価格について
本価格は現中古販売価格の「値下げ前価格」となります。
直近約1か月間、値下げ前価格での販売実績があるものだけ表示しております。
音声認識システム 改訂2版
¥3,850
在庫なし
商品レビュー
3
1件のお客様レビュー
現在の音声認識技術は、統計モデルにその基盤をおいており、音響モデルには大量の音声データ、言語モデルには、大量のテキストデータが必要不可欠である。 音響モデルでは、音声波形から音声認識に必要な言語情報(音韻情報)に対応する物理的な特徴量(音声特徴量)を抽出する。パターン認識モデルを...
現在の音声認識技術は、統計モデルにその基盤をおいており、音響モデルには大量の音声データ、言語モデルには、大量のテキストデータが必要不可欠である。 音響モデルでは、音声波形から音声認識に必要な言語情報(音韻情報)に対応する物理的な特徴量(音声特徴量)を抽出する。パターン認識モデルを使い、音声特徴量から音素に変換することで、音声を音素に分解していく。分解された音素モデルを連結することで単語モデルを構成し、最も高い確率で観測された音響特徴量をを出力するモデルに対応する単語を決定する。さらに単語間の接続規則として与えられた文法を満たすさまざまな文仮説の中から、最も高い確率で観測音響特徴量を出力する文を決定する。 言語モデルの現在の主流は、サンプルデータから統計的な手法によって、確率推定を行う統計的言語モデルである。最も単純なNグラムモデル、中間層の出力をフィードバックさせるリカレントニューラルネットワーク(RNN)や、より学習を効果的に行えるようにしたLSTNなどが使われている。 音声認識システムの実現例として、オープンソースで誰でも使えるJulius、研究開発を行うシステムとしてのKaldi、国会審議の音声認識システムなどがある。
Posted by 
関連商品
同じジャンルのおすすめ商品
同じジャンルのおすすめ商品
最近チェックした商品
お手持ちのスマホでスキャン